MiniMax H3发布:开放多模态视频模型进入2K与原生音频阶段
MiniMax 官方发布 H3,强调文本、图像、视频与音频的统一上下文理解,并支持2K画质、最长15秒、原生立体声音频的视频生成。其开放模型路线,对出版融合传播、海外短视频生产和内容资产再表达具有观察价值。
官方发布要点
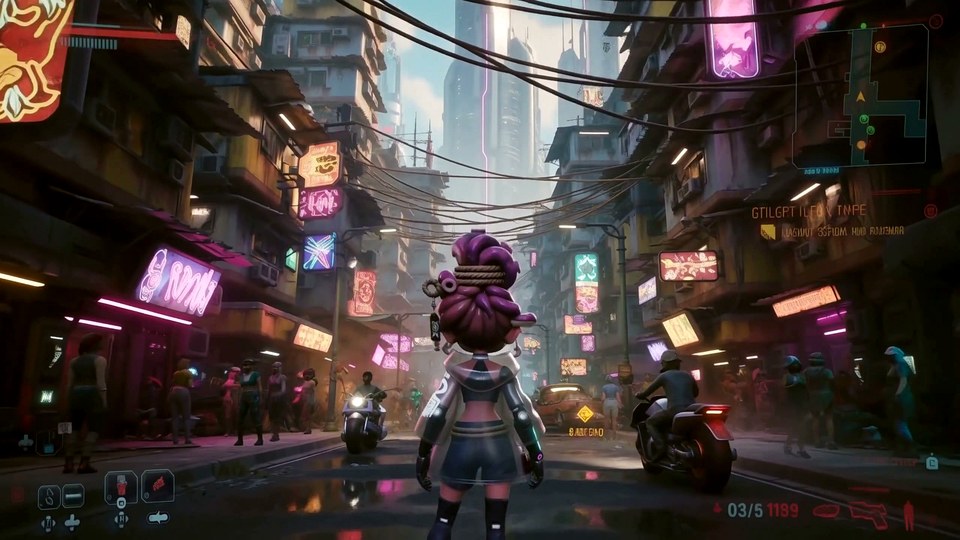
官方发布页展示 MiniMax H3 在图像、视频、音频与文本统一理解方面的能力,并突出视频生成画质、时长和原生音频等方向。
其开放模型路线有利于开发者、内容团队和机构用户围绕具体场景进行二次开发、流程嵌入和能力评估。
出版融合观察
对出版融合传播而言,H3 值得关注的不是单一视频效果,而是多模态内容资产如何进入选题宣传、课程传播、海外视频分发和知识服务流程。
实际应用中仍需关注人物肖像、素材授权、输出内容准确性、平台分发规则和生成合成内容标识,尤其是面向海外传播和商业发布的场景。
小编观察
网站编辑观点
开放模型路线给出版融合传播带来更多实验空间
MiniMax H3 值得关注的一点,是把视频、图像、音频和文本放到统一上下文中理解与生成。对出版融合传播而言,这类能力可以服务海外短视频、课程片段、图书视觉营销、数字人讲解和内容资产二次表达。
开放模型并不等于可以无边界使用。出版机构在引入模型能力时,应优先把它放进受控流程:先做内部样片、再做人工审读、再做版权和标识确认,最后进入正式传播。这样才能让技术创新和出版责任并行。
- 适合用于海外传播样片、课程片段和多语种内容试验
- 应重点评估音画同步、事实表达和人物肖像授权
- 建议会员单位形成“模型试用—审校—归档—发布”的闭环
留言与意见
留言与意见
当前不预置任何游客评价。填写内容只保存在您的本机浏览器,不会自动上传或公开;正式公开留言须经过审核。
暂无经审核公开的留言。